~/projects/argus.md
Argus — 纯前端长视频理解 Agent Harness
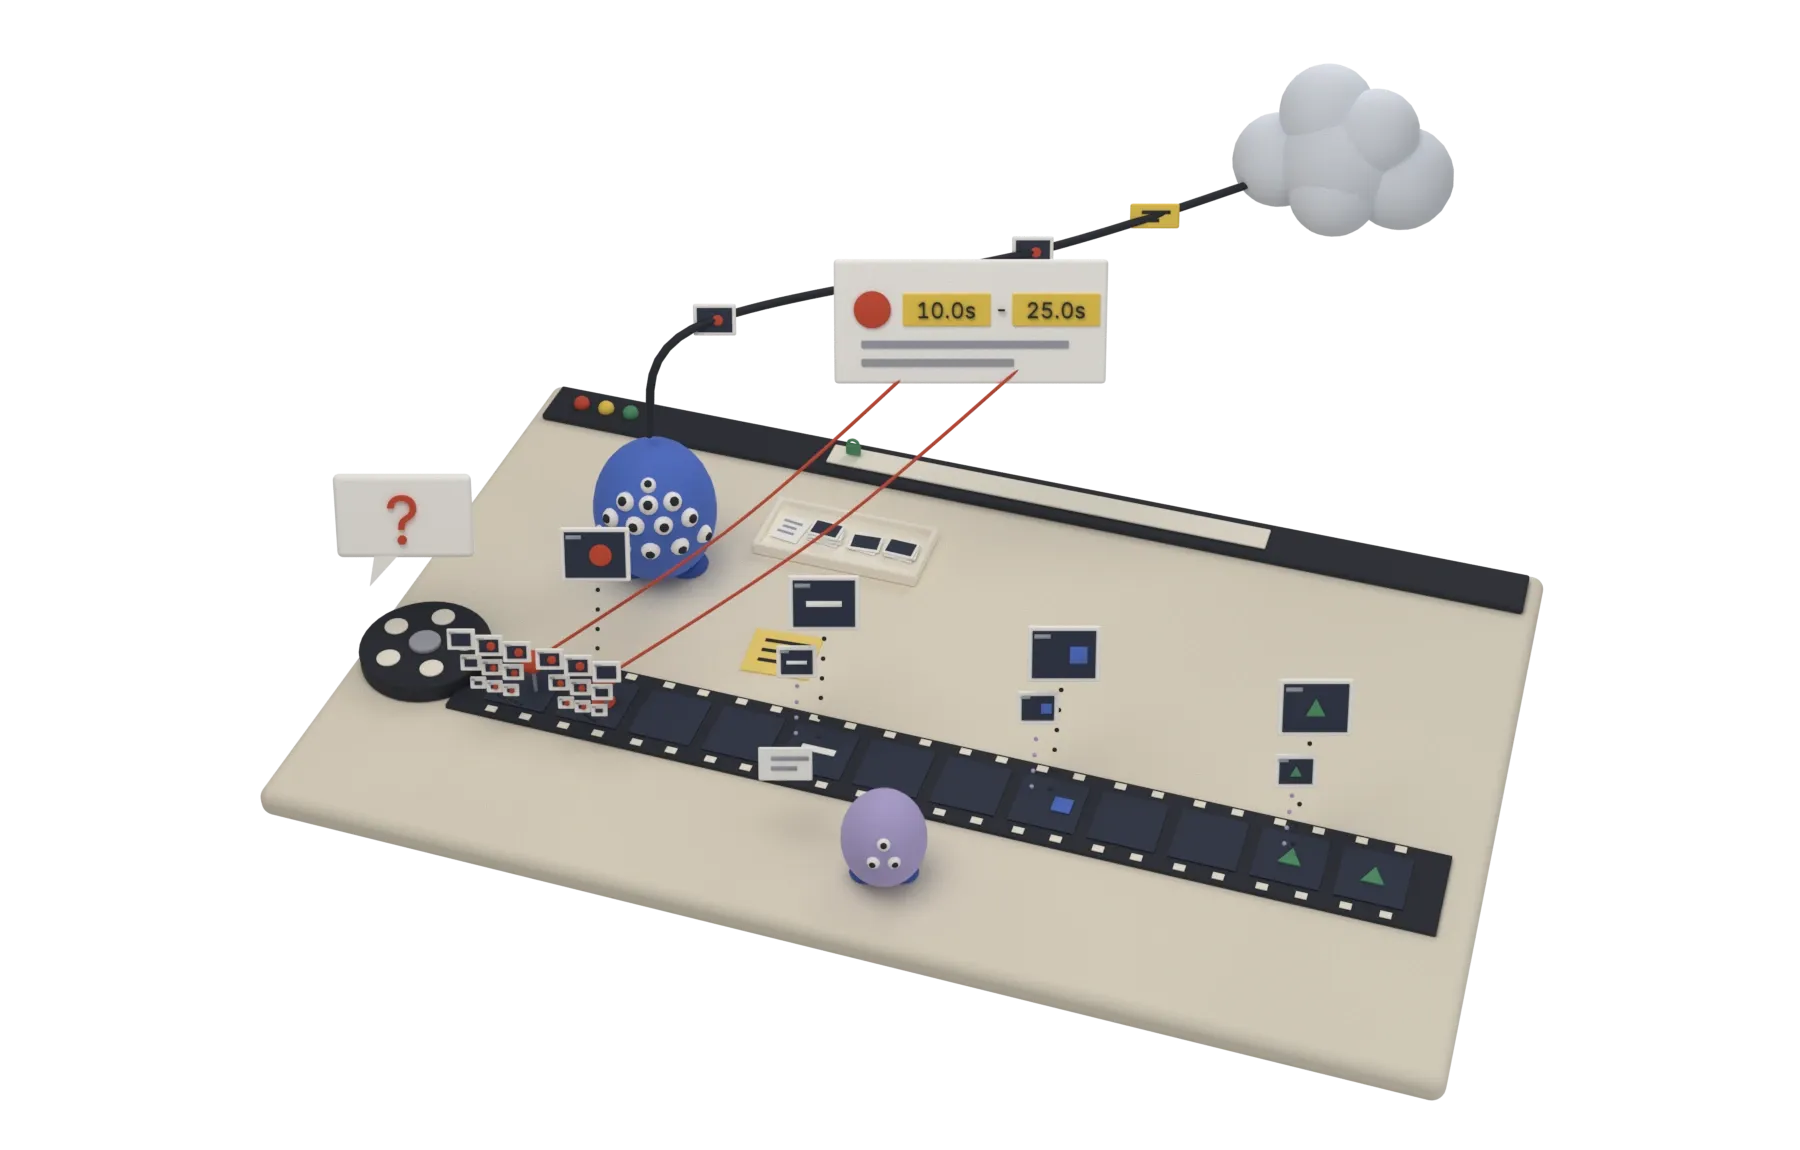
Argus(取名自希腊百眼巨人 Argus Panoptes)是我独立设计开发并开源的长视频理解 agent harness——只有前端、没有后端,视频完全在浏览器本地解码处理,API Key 与模型全部用户自填。让多模态 LLM agent 自己调用工具去”看”视频:抽帧、局部放大、记笔记、派子代理,典型场景如监控视频数人数、找特定物品。
它解决什么
让 LLM 理解长视频的痛点不在模型,而在怎么把视频喂给它:整段上传太贵,盲抽帧又漏信息。Argus 把这个问题交给 agent 自己决策——它先看视频元信息,再自主决定抽哪些帧、用什么频率、哪里需要放大细看,上下文要爆了就派子代理分段处理。同时视频文件不离开你的浏览器,也没有后端:发给模型的只有 agent 挑出来的缩小帧和文字。
架构亮点
- Agent 循环 — 由 Vercel AI SDK
streamText驱动多步工具调用(stopWhen限制步数),产品的核心两处自己写:prepareStep把新抽的帧作为一条用户消息注入下一步,任何视觉模型都看得到(工具结果里带图,在各家 OpenAI 兼容网关之间不通用);旧图自动裁掉(只留最近 3 批,更早的换成一行字,要用时再抽回来),长任务的上下文不会失控。 - 8 个视频理解工具 —
get_video_info/extract_frames(范围+频率抽帧带时间戳)/extract_frame_at/list_frames/inspect_region(局部放大细看)/remember/recall(状态记忆,防长上下文遗忘)/spawn_subagent(超长视频分段,防上下文爆炸)。 - 浏览器本地硬解码抽帧 — 主路径用 mediabunny(基于 WebCodecs 解封装 + 解码,不用拖
<video>的进度条);解不了时退回<video>+<canvas>(含黑帧重试);AVI / WMV / FLV 这类容器第一次遇到时才从 CDN 懒加载 ffmpeg.wasm 在本地转码;mediainfo.js 只在退回路径上补 fps / 编码 / 码率。 - 211 个 Provider 运行时目录 — 接入 models.dev 目录并归一化为 provider 预设,下拉可搜;自动标记视觉模型并优先默认选中(适配视频理解);OpenAI 兼容 / Anthropic / Gemini 三类传输自动判定,附带 CORS 提示与连接测试。
- 子代理隔离上下文 — 子代理 = 去掉
spawn_subagent工具的嵌套 agent 运行,长视频分段理解的中间过程不污染主上下文。
技术栈
前端 · Vite 8 + React 19 + TypeScript 7(native tsc)+ Tailwind 4 + zustand
LLM 接入 · Vercel AI SDK(ai + @ai-sdk/openai / @ai-sdk/anthropic / @ai-sdk/google,均支持自定义 baseURL)· models.dev provider 目录
基建 · GitHub Actions CI/CD · 双线发布(国内阿里云 CDN + OSS,海外 Cloudflare Pages)· Let’s Encrypt DNS-01 证书自动续期
工程实践
- 零后端 — 纯静态站点,构建产物 7 个文件即可双线发布;用户 API Key 仅存浏览器本地。
- 同产物双线发布 — 国内(阿里 CDN→OSS)与海外(Cloudflare Pages)从同一次构建的
dist/发布,DNS 分线路由,保证两条线内容一致。 - 证书自动化 — 每周自动检查国内 CDN 证书,剩余不足 30 天走 DNS-01 免费续签并做边缘核验。
我的角色
独立完成:产品设计 · Agent harness 架构 · 前端实现 · 多 provider 接入 · CI/CD 双线部署——从 0 到开源发布,一个人全链路。
开源项目,源码见 GitHub。