Codex 为什么不把所有工具都交给模型? — 讲透 tool_search、BM25 与模型替换
把模型想成只有一张小桌子的工程师。工具说明书有几百本时,全部摊在桌上既贵又难找;更好的办法是先给它一本目录,需要什么再取出最相关的几本。本文就讲清 Codex 怎样做这件事、为什么使用 BM25 排序,以及怎样把同一办法搬到 Python、Go 和其他模型上。
目录 · index
- 这篇文章写给谁
- 先只记住四句大白话
- 全文只需要认识四样东西
- 为什么很多工具要收进 exec
- 模型第一次到底能看到什么:先分清公开 API 与 Codex 内部封装
- GPT-5.6 Sol/Terra 第一次能直接点哪些入口
- exec 里面又有哪些工具
- 那 tool_search 到底在不在第一次请求里
- 一次工具搜索到底怎样发生
- 从几百份说明书缩到几份,真正省了什么
- BM25 不是“不要关键词”,而是“给关键词排座次”
- 源码深挖(可以跳过):Codex 怎样接上 BM25
- 换成 Python 或 Go,照样能做
- 为什么这个场景选 BM25 很合理
- BM25 的边界也很清楚
- BM25 能不能用来搜索记忆
- 开源 Codex 可以换模型,但不是只改一个名字
- 最值得带走的七点
- 源码索引
本文固定在 2026-08-07 发布的稳定版 rust-v0.147.0,源码 commit 为 be6e8eac;另复查了 2026-08-09 的 main commit 646f7c0a。先给两个不会误导人的结论:
- 模型第一次能看到哪些工具,不是一张永远不变的名单。 它会随模型、接入方式、运行环境和功能开关变化。
tool_search和背后的 BM25 排序代码都已经写好,普通直连方式可以使用;但这个稳定版给 GPT-5.6 采用的exec集中调用方式漏掉了搜索入口。 这不是功能没开发,而是一条接线没有接通。
这篇文章写给谁
默认读者只需要知道“大模型可以调用外部工具”。不要求会 Rust,也不要求读过 Codex 源码。 如果你主要写 Python 或 TypeScript,后面的 Rust 连写可以直接理解成“筛选列表 → 改造每一项 → 收集结果”。
有两条阅读路线:
- 只想理解做法:读小桌子问题、机场图、工具搜索过程、跨语言复用和模型替换;
- 想跟进源码:继续读伪代码、Rust 对照、完整查询实例和源码索引。
先只记住四句大白话
先把 Rust 函数名和 OpenAI 的专有叫法全部擦掉,一个会使用工具的模型仍逃不开四件事:
- 模型只能使用它看得见的工具。 真正干活的代码即使已经写好,没有把工具说明交给模型,模型也不知道它存在;
- 模型眼前的空间有限,而且放进去的每个字都要付出费用和时间。 工具越多,重复发送的说明书越长,模型也越容易选错;
- 搜索就是先缩小范围。 先从几百个工具里排出最相关的几个,再让模型选择,比让它同时读几百本说明书更稳;
- Agent 外壳和大模型可以分开。 只要双方对“问题怎样发、工具怎样调用、结果怎样交回”达成一致,编程语言、搜索方法和模型都可以替换。
因此全文最小的知识骨架其实只有这一条:
查看源码(Mermaid)
mermaid6 行代码
flowchart TD
    A["模型眼前的空间有限"] --> B["不能一直摆着所有工具说明书"] --> C["先给少量常用工具和一本目录"] --> D["搜索并取出排名靠前的几份完整说明"] --> E["模型调用"] --> F["程序真正执行,再把结果交回模型"]
    classDef cause fill:#fff3bf,stroke:#f08c00
    classDef out fill:#d3f9d8,stroke:#2f9e44
    class A cause
class F out理解这条链以后,下面哪些必须保留、哪些可以摘掉就很清楚:
| 阅读源码时看到的内容 | 是否必须理解 | 原因 |
|---|---|---|
| 工具是一开始就给、搜索后再给,还是完全不给 | 必须 | 它决定模型在什么时候看见什么 |
可搜索文字 → 排名后的编号 → 完整工具说明 | 必须 | 这是可以搬到任何 Agent 的核心做法 |
| 模型接入层怎样收发数据、支持哪些能力 | 必须 | 它决定能否安全替换模型 |
| Rust iterator、具体类型名、文件路径 | 可以先摘掉 | 它们是本项目实现,不是架构定律 |
bm25 crate 名称与数组下标技巧 | 可以替换 | Python、Go 或数据库检索都能实现同一接口 |
| GPT-5.6 当前工具名单 | 只能当版本快照 | 模型、环境和功能开关改变后会重新计算 |
全文只需要认识四样东西
| 白话名字 | 它是什么 | 源码里偶尔出现的名字 |
|---|---|---|
| 工具说明书 | 工具叫什么、能做什么、需要哪些参数 | Schema / Tool Spec |
| 工具总表 | 程序目前知道的全部工具;不等于全部都交给模型 | Registry |
| 真正干活的代码 | 模型点名某个工具后,负责执行它的程序 | Runtime / Handler |
| 模型接入层 | 把 Codex 的请求翻译成模型服务能够收发的格式 | Provider |
后文再次出现英文原名时,它只是为了和源码对照。理解正文不需要背这些词。
为什么很多工具要收进 exec
这里讨论的不是“用户只能写代码”的聊天模式,而是工具以什么方式交给模型:
| 白话说法 | 源码名称 | 模型看到什么 |
|---|---|---|
| 每个工具单独摆出来 | Direct | 多数工具都有自己的调用入口 |
| 常用的单独摆,其他收进总入口 | Code Mode | 一部分工具直接调用,另一部分通过 exec 里的 tools.xxx() 调用 |
| 几乎都收进总入口 | Code Mode Only | 模型主要写一小段 JavaScript,通过 exec 统一调用;只有 wait 等少量入口仍单独保留 |
在本文稳定版里,GPT-5.6 Sol 的模型配置已经写明采用“几乎都收进 exec”的方式。选择这个模型后 Codex 会自动采用,不需要在 UI 里再开一个按钮。 源码也保留了下面这个实验开关,方便开发者测试其他模型:
toml2 行代码
[features]
code_mode_only = trueCLI 也可临时传 codex --enable code_mode_only。公开配置仍把它标成“开发中”;模型没有经过这种调用方式的训练和验证时,强行开启可能让表现变差。因此它适合测试,不适合对任意模型盲开。--code-mode-host 是另一回事,它只决定这段工具编排代码在哪里运行。
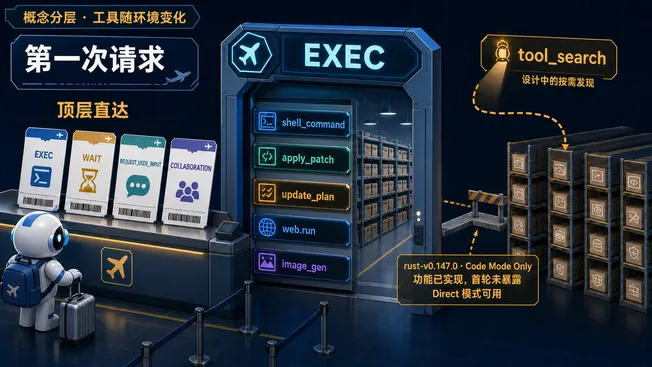
现在再看分层图。它同时画出“设计中的延迟发现”与“稳定版 Code Mode Only 的首轮实际状态”;虚线和路障表示 tool_search 已实现,但在这个特定首轮工具布局中没有暴露给模型。
模型第一次到底能看到什么:先分清公开 API 与 Codex 内部封装
先纠正一个很容易造成误解的说法:开发者直接调用 OpenAI 公开 Responses API 时,即使用 GPT-5.6,工具仍然放在顶层 tools。不应该因为 Codex 源码里出现了 additional_tools,就把自己的公开 API 请求改成这个写法。
这里其实混在了一起的是两个问题:
- 模型能使用哪些工具:取决于服务最终交给模型哪些工具说明;
- 这些说明怎样穿过网络送到服务:取决于客户端和服务端约定的请求格式。
模型不会亲自阅读 HTTP 包并比较 JSON 键名。服务端会先把请求还原成“模型可调用的工具”。所以 tools 与 additional_tools 更像是两种信封:信封写法不同,里面都可以装同一份工具说明书。真正受这个区别影响的是客户端能否与服务端对上格式,而不是模型突然多了或少了某种推理能力。
对比一:开发者直接调用公开 Responses API
下面是一份完整的最小请求。为了让两边能逐项比较,只放一个 weather 工具组:
bash37 行代码
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.6",
    "instructions": "需要实时天气时调用工具,不要猜测。",
    "input": [
      {
        "role": "user",
        "content": "巴黎现在多少度?"
      }
    ],
    "tools": [
      {
        "type": "namespace",
        "name": "weather",
        "description": "查询实时天气。",
        "tools": [
          {
            "type": "function",
            "name": "get_current_weather",
            "description": "按城市查询当前温度。",
            "parameters": {
              "type": "object",
              "properties": {
                "city": { "type": "string" }
              },
              "required": ["city"],
              "additionalProperties": false
            },
            "strict": true
          }
        ]
      }
    ],
    "tool_choice": "auto"
}'这里有三条彼此平行的输入:instructions 告诉模型做事原则,input 装用户问题,tools 装可以调用什么。工具既不是系统提示词里的自然语言清单,也不是用户消息的一部分。
对比二:Codex 选择 Responses Lite 后发出的请求
Codex 的稳定版模型配置会为 GPT-5.6 Sol 选择 use_responses_lite。此时源码仍然构造一个 Responses 请求体,但做了两次搬家:顶层 tools 搬到 input 的第一项,顶层 instructions 搬到第二项。下面仍用同一个人为示例的 weather 工具组,方便逐字段比较;字段位置和固定值来自源码,尖括号中的缓存键与追踪值则由 Codex 每轮生成:
http68 行代码
POST <Codex 当前模型接入层配置的 Responses 地址>
Authorization: Bearer <当前登录或 API 凭据>
Content-Type: application/json
x-openai-internal-codex-responses-lite: true

{
  "model": "gpt-5.6-sol",
  "input": [
    {
      "type": "additional_tools",
      "role": "developer",
      "tools": [
        {
          "type": "namespace",
          "name": "weather",
          "description": "查询实时天气。",
          "tools": [
            {
              "type": "function",
              "name": "get_current_weather",
              "description": "按城市查询当前温度。",
              "parameters": {
                "type": "object",
                "properties": {
                  "city": { "type": "string" }
                },
                "required": ["city"],
                "additionalProperties": false
              },
              "strict": true
            }
          ]
        }
      ]
    },
    {
      "type": "message",
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "需要实时天气时调用工具,不要猜测。"
        }
      ]
    },
    {
      "type": "message",
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "巴黎现在多少度?"
        }
      ]
    }
  ],
  "tool_choice": "auto",
  "parallel_tool_calls": false,
  "reasoning": { "effort": "low", "context": "all_turns" },
  "store": false,
  "stream": true,
  "include": ["reasoning.encrypted_content"],
  "prompt_cache_key": "<由 Codex 会话生成>",
  "text": { "verbosity": "low" },
  "client_metadata": {
    "x-codex-turn-metadata": "<由 Codex 生成的 JSON 字符串>"
  }
}最值得注意的不是字段多了一个,而是请求头已经明确写着 internal-codex-responses-lite。Codex 的源码测试也明确检查:这种请求没有顶层 tools 和 instructions,input[0] 必须是 additional_tools,下一项才是 developer 指令。它是 Codex 与支持该格式的模型服务之间的内部传输合同,不是公开 Responses API 文档要求普通开发者采用的新格式。
| 精准对比 | 公开 Responses API | Codex Responses Lite |
|---|---|---|
| 面向谁 | 普通 API 开发者 | Codex 与明确支持 Lite 的模型接入层 |
| 工具放哪里 | 顶层 tools | input[0].tools,这一项的类型叫 additional_tools |
| 基础指令放哪里 | 顶层 instructions | 下一条 developer 消息 |
顶层 tools 是否存在 | 存在 | 源码设为 None,发出时省略 |
| 是否公开、通用 | 是 | 否,请求头明确标记为 Codex internal |
| 模型最终是否能看到工具 | 能 | 服务端支持这份内部合同才能看到 |
因此,之前真正应该表达的区别不是“GPT-5.6 改用了新的公开 API”,而是:同一个 Codex 客户端内有两种请求编码;模型目录为某些模型选择了内部 Lite 编码。 在 Lite 路径里,第一次可见的入口仍分两种:exec、wait 等入口可以直接点名;收在 exec 使用指南里的工具也能被读到,但要写成 tools.xxx(...) 调用。
这和机场很像:公开 API 与 Lite 是两家航空公司的登机牌版式,不是两座不同的机场。exec 则像其中一张联程票,票面已经写明过闸后可以到哪些柜台。
GPT-5.6 Sol/Terra 第一次能直接点哪些入口
在默认 App/CLI 配置、存在执行环境、未被企业策略关闭的前提下,核心顶层入口可以归纳为:
| 首轮顶层入口 | 它给模型的能力 | 为什么留在顶层 |
|---|---|---|
exec | 执行一段 JavaScript,在同一个 cell 里编排多个嵌套工具,并只返回压缩后的结果 | Code Mode 的总入口,减少多次模型—工具往返 |
wait | 等待先前 yield 的长时间 exec cell | 等待期间不占住一次长工具调用 |
request_user_input | 在允许的协作模式中向用户提短问题 | 它是人与 Agent 的控制面,不适合藏进代码编排 |
collaboration | 一组多 Agent 协作动作,包含创建、发消息、等待和中断子 Agent 等 | 这些动作负责协调多个 Agent,源码选择让它们保持直接可用 |
collaboration 看起来是一个入口,里面实际装着六个协作动作。Luna 使用另一套多 Agent 方式,所以第一次看到的入口会不同;达到子 Agent 层数限制后,协作入口还可能被关闭。
exec 里面又有哪些工具
exec 不是 Shell 的别名,而像一张能在候机楼内转乘的通票。Codex 会把命令执行、文件修改、外部服务和工作编排等能力汇总进去。常见成员如下:
| 类别 | 常见工具 | 出现条件 |
|---|---|---|
| 命令执行 | Windows 常见 shell_command;启用 Unified Exec 时是 exec_command + write_stdin | 必须有执行环境;具体形态由模型与 Feature 决定 |
| 文件修改与检查 | apply_patch、view_image | 模型支持相应工具,且当前环境允许 |
| 工作编排 | update_plan | 配置默认开启,可显式关闭 |
| MCP 资源 | list_mcp_resources、list_mcp_resource_templates、read_mcp_resource | 至少连接了一个 MCP Server |
| App 扩展 | web.run、image_gen.imagegen | 模型接入、登录状态、图片能力和网络均满足条件 |
| 插件安装 | request_plugin_install,有时还有候选列表工具 | Apps、Plugins、ToolSuggest 开启且确有候选项 |
| 其他扩展 | Goal、自动化、App Server 动态工具等 | 相应扩展已经安装或由客户端加入 |
所以“真正干活的代码已经写好”不等于“模型第一次就能看到这个工具”。程序还要依次决定:把工具加入总表 → 判断一开始就给、搜索后再给还是不给 → 决定是否收进 exec → 生成最终请求。运行环境缺失、功能关闭、模型服务不支持、账号权限不足或工具重名,都可能让某个工具中途消失。
那 tool_search 到底在不在第一次请求里
程序只有同时满足两件事,才会把 tool_search 加入工具总表:
- 当前模型声明“我会使用工具搜索”,模型接入层也支持成组工具;
- 工具总表里确实存在至少一个“需要搜索后再给模型”的工具。
在 rust-v0.147.0 中,外部 MCP 工具可以先进入工具总表,但标记成“搜索后再给”。这样它们的完整说明书不必全部塞进第一次请求。模型调用 tool_search 后,程序才把最相关的完整工具说明放进下一次请求,默认最多返回 8 个。
这里有一个容易错过的源码细节:GPT-5.6 采用“几乎都收进 exec”的方式时,负责组装工具的代码恰好跳过了 tool_search。 同时,这种方式又会隐藏 exec、wait 之外的普通独立入口。因此:
- 每个工具单独摆出来时,只要存在“搜索后再给”的工具,
tool_search就可以成为第一次请求里的独立入口; - GPT-5.6 采用
exec集中调用时,BM25 排序代码即使已经准备好,tool_search也不会进入模型第一次可调用的名单;模型看不见入口,自然无法发起搜索; - 这正是公开 issue #32101 描述的桥接缺口。截至 2026-08-09,
main的 commit646f7c0仍保留该跳过分支。
这一区分很重要:程序知道一个工具存在,不等于模型看得见;设计上准备了搜索,也不等于每种工具摆放方式都已接通。
一次工具搜索到底怎样发生
先暂时放下上面的接线缺口,观察一条模型确实能看见 tool_search 的正常路径。搜索不是每轮固定执行,而是模型可以选择的一个动作。
不是每轮自动重搜,而是模型按需决定
Codex 没有一段“现有工具都不合适,就自动执行 BM25”的兜底程序。只有模型主动发出 tool_search_call,Codex 才真正开始搜索。模型可以直接使用手边的工具,也可以一开始就查目录,不需要先把现有工具逐个试错。
可以把它想成开发者走进五金店:手边已有锤子和螺丝刀,店员还能查后仓。拧螺丝时不必每走一步都查一次;遇到“测光纤”这类货架外需求时,才去翻目录。查出来的工具说明只要还留在本次会话里,后面就能继续使用,不必每轮重复搜索同一个工具。只有需求变了、工具目录更新、开启新任务,或旧结果已经不在模型眼前时,才需要再搜。
OpenAI 的通用做法会先给模型一点点“可发现信息”,例如某组工具叫什么、能做什么,但把冗长参数留到搜索命中后再发。Codex 的本地 BM25 路径则先给模型 tool_search 入口和可搜索范围,命中后再返回完整工具说明。共同点都是:先给目录,不先搬来整个仓库。
开发新 Agent 时,到底要不要使用这个区别
先从第一性原理判断:一个 Agent 只需要打通四件事——你有哪些工具 → 模型收到哪些说明 → 模型用什么格式提出调用 → 你的程序怎样执行并返回结果。tools 与 additional_tools 只属于第二件事的“运输包装”,不应该侵入你的业务工具代码。
| 你的场景 | 应该怎样做 | 不应该怎样做 |
|---|---|---|
| 直接使用 OpenAI 公开 Responses API | 继续使用顶层 tools;需要官方工具搜索时,在这里加入 tool_search 和标记为延迟加载的工具 | 不要自己构造 additional_tools |
| 工具数量很少 | 直接把完整工具放进 tools,先保持系统简单 | 不要为了模仿 Codex 强行增加一层搜索 |
| 工具有几百个,而且创建请求时已经知道完整目录 | 使用官方托管的 tool_search,让 OpenAI 服务完成搜索与加载 | 不必先复制 Codex 的本地 BM25 |
| 工具随租户、项目或权限实时变化 | 使用客户端执行的 tool_search;模型提出搜索,你的程序用 BM25、向量或混合方法查找,再回传 tool_search_output | 不要把所有租户的全部工具都发送给模型 |
| Fork Codex,且模型服务明确支持 Responses Lite | 保留 Codex 的接入层,让它负责生成 additional_tools 和内部请求头 | 不要让业务代码直接依赖这份内部格式 |
| 接 DeepSeek、GLM、Kimi 或本地模型 | 在 Agent 内部保留统一的工具说明,再为每个模型写一个很薄的格式转换层 | 不要假设对方认识 OpenAI 的内部 additional_tools |
如果你现在用公开 Responses API 开发一个有大量工具的新 Agent,真正可以直接复用的是下面这种官方写法,而不是 Lite 写法:
python34 行代码
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6",
    input="列出客户 CUST-12345 的未完成订单。",
    tools=[
        {
            "type": "namespace",
            "name": "crm",
            "description": "客户资料与订单工具。",
            "tools": [
                {
                    "type": "function",
                    "name": "list_open_orders",
                    "description": "按客户 ID 查询未完成订单。",
                    "defer_loading": True,
                    "parameters": {
                        "type": "object",
                        "properties": {
                            "customer_id": {"type": "string"}
                        },
                        "required": ["customer_id"],
                        "additionalProperties": False,
                    },
                    "strict": True,
                }
            ],
        },
        {"type": "tool_search"},
    ],
    parallel_tool_calls=False,
)这段代码表达的设计才值得带走:先给模型 crm 这本目录,需要时再加载 list_open_orders 的完整参数。至于底层最终用顶层 tools、Lite 输入项,还是另一个模型厂商的格式,应由最外层的模型接入代码转换。
搜索结果怎样进入上下文,又能用多久
一次客户端执行的完整时序如下:
text5 行代码
模型:tool_search_call(query="calendar")
Codex:BM25 排出前几个 → 取回完整工具说明
上下文尾部:tool_search_output { call_id, status, tools: [...] }
模型:function_call(name="create_event", ...)
后续轮次:仍可调用已加载的 create_eventtool_search_output 是请求里专门存放搜索结果的数据块,不是 system 文本或 user 文本,也不会回头修改第一次的 additional_tools。Codex 会把“搜索请求”和“搜索结果”一起记进会话历史。下一次请求带上这段历史后,模型就能使用结果里的完整工具说明。新内容放在上下文末尾,还能尽量保持前半部分不变,提高缓存复用机会。
“以后都能用”要加一个边界:它指同一活跃会话里,该输出仍在传给模型的上下文中。它不是进程级永久安装;新会话、上下文压缩策略或工具目录更新,都可能重新触发发现。可以把它想成把后仓取来的说明书夹进本次工单,而不是把机器永久焊在工作台上。
为什么稳定版只给 GPT-5.6 选择 Code Mode Only
源码能证明的是:稳定版给 GPT-5.6 Sol、Terra、Luna 都选择了“几乎都通过 exec 调用”的方式,GPT-5.5 没有。源码只把它记录成这个模型适合哪些调用方式,并没有写“因为 5.6 更聪明,所以开启”。而且 tool_search 本身并非 5.6 独占,官方文档说 GPT-5.4 及更新模型也支持。
下面是工程推断,不是源码原话:这种方式要求模型写对 JavaScript、按工具说明填写参数、处理异步和错误,还要在一次执行里筛选结果。更强的代码、推理和工具调用能力显然有帮助;但能否开启还取决于专门训练、评测、模型服务是否支持和发布策略。“强模型让它更可行”是合理解释,“只因为模型更强”则过度简化。
从几百份说明书缩到几份,真正省了什么
假设 Agent 接入 N 个工具,每份完整说明平均占 S 个 Token。全部塞给模型时,一轮请求里的工具部分近似是:
text1 行代码
Full cost ≈ N × S改成“需要时再加载”后,平时只放搜索入口和简短目录,命中后只取 K 个工具:
text1 行代码
按需加载 ≈ 简短目录 + 搜索入口 + K × S当 K ≪ N,节省的不只是 Token。模型面对的相似名称和参数组合变少,最终 Tool 选择也更容易。严格说,tool_search 没有提高模型参数中的“智力”;它通过减少噪声、提供恰当信息、把大决策拆成两次小决策,提高了 Agent 的有效智能。
这不是无条件免费:搜索会多一次“模型 → 搜索程序 → 模型”的往返,还可能漏掉正确工具。只有十几个工具、每轮几乎都会用时,全部摆出来可能更快;工具达到几百或几千、每次只用少数时,先搜索再取前几个才明显占优。这个判断不依赖 Codex 或 Rust。
BM25 不是“不要关键词”,而是“给关键词排座次”
常有人问:为什么不用关键词匹配,反而用 BM25?其实 BM25 仍然在匹配关键词,只是会给结果排先后。它不真正理解词义,也不知道“订会议”和“安排日程”表达的是同一件事。普通匹配只回答“有没有这个词”,BM25 还会判断“哪一张工具卡更值得排在前面”。
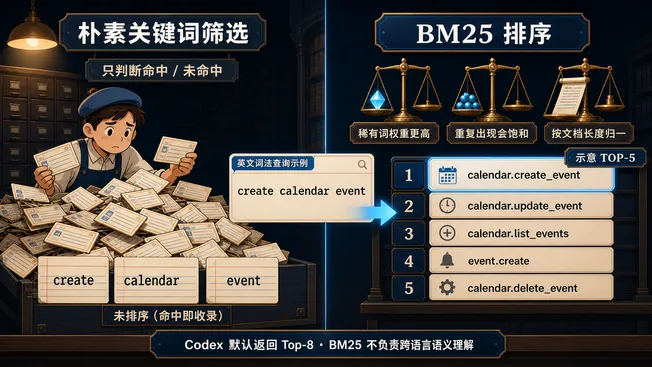
先用一条概念式记住三个力:
text1 行代码
score(D, Q) = Σ IDF(t) × TF_saturation(t, D) × length_normalization(D)这不是代码里的完整公式。bm25 2.3.2 实际采用的标准形式是:
text4 行代码
score(D, Q) = Σ IDF(qᵢ) ×
              f(qᵢ,D) × (k₁ + 1)
              ─────────────────────────────────────────
f(qᵢ,D) + k₁ × (1 - b + b × |D| / avgdl)其中 f(qᵢ,D) 是查询词在这张工具卡里出现的次数,|D| 是卡片长度,avgdl 是全部卡片的平均长度。Codex 直接调用 with_documents(...).build(),没有覆盖参数,因此使用 crate 默认值 k₁ = 1.2、b = 0.75;建索引时会由整批文档拟合 avgdl。换句话说,Codex 负责“把哪些工具卡交给馆员”,crate 负责“分词、统计和按公式排队”。
仍用图书馆来理解:
- 稀有词更值钱(IDF):几乎每张工具卡都写着
get,它像“本馆藏书”一样没什么区分度;只有少数卡片写着calendar,这个词更能定位目标; - 重复会饱和:描述里写三次
calendar可以增强信号,但不会比写一次机械地强三倍,避免关键词堆砌霸榜; - 长描述要归一:一本厚说明书天然更容易碰到查询词,BM25 会校正长度,避免“写得最多”自动等于“最相关”;
- 直接排出前几个:
tool_search默认需要 8 个按相关程度排好的候选,而不是一大包无序的“命中 / 未命中”。
Codex 不只搜索工具名。它会把原名、把下划线换成空格后的名字、用途说明、参数名和参数说明拼成一张可搜索卡片。例如同时写入 create_event 和 create event,可以让搜索程序分别看到 create 与 event。外部 MCP 工具还会加入服务名、标题、插件名等信息。卡片写得越接近用户真正会说的话,越容易搜对。
源码深挖(可以跳过):Codex 怎样接上 BM25
如果只想把设计搬进自己的 Agent,记住“工具卡 → BM25 排名 → 用编号取回完整工具说明”已经够了。下面这一节只负责用真实源码证明三件事:工具卡从哪里来、排名结果怎样找回工具、工具说明怎样交给下一轮模型。
先说最容易误解的一点:Codex 没有自己手写一遍 BM25 公式。 codex-rs/Cargo.toml 依赖 bm25 = "2.3.2",分词、文档频率、平均文档长度和评分由这个内存检索库完成;Codex 写的是围绕它的数据准备与结果映射。
不懂 Rust 也可以先把实现读成四行伪代码:
text4 行代码
cards = deferred_tools.map(search_text + loadable_schema)
engine = BM25.build(cards.search_text)
ids = engine.search(query, limit = 8)
return merge(cards[id].loadable_schema)下面的 Rust 代码只是这四步的强类型版本;可以把 .filter()、.map()、.collect() 分别当成列表的筛选、转换和收集。
第一步:只收集“需要搜索后再给”的工具
append_tool_search_executor() 从工具总表里挑出“需要搜索后再给”的工具,再向真正管理该工具的代码索取可搜索文字。下面保留真实源码名称,方便核对:
rust9 行代码
let search_infos = registry
    .entries()
    .filter(|tool| tool.exposure.is_deferred())
    .filter_map(|tool| tool.runtime.search_info())
    .collect::<Vec<_>>();

registry.register_trusted(
    tool_search_handler_cache.get_or_build(search_infos, source_listing),
);每个条目把“用于搜索的卡片文字”和“命中后要返回的工具定义”绑在一起:
rust4 行代码
pub struct ToolSearchEntry {
    pub search_text: String,
    pub output: LoadableToolSpec,
}search_text 是卡片正面,用来搜索;output 是卡片背面,保存命中后要交给模型的完整工具说明。它就像图书馆索引卡:正面供馆员查找,背面写着怎样取到真正的书。
第二步:给每张卡一个数字编号
ToolSearchHandler::new() 枚举所有卡片,把 search_infos 的数组下标作为 BM25 文档 ID:
rust13 行代码
let documents = search_infos
    .iter()
    .map(|info| info.entry.search_text.clone())
    .enumerate()
    .map(|(idx, text)| Document::new(idx, text))
    .collect();

let search_engine =
    SearchEngineBuilder::<usize>::with_documents(
        Language::English,
        documents,
    )
.build();这个 usize 很关键。BM25 引擎只需返回诸如 7、2、11 这样的有序文档 ID,Codex 就能用它们回查 search_infos[7]、search_infos[2]、search_infos[11]。没有数据库主键,也没有第二张映射表,数组位置本身就是“取书号”。整个语料一次性装进内存,并明确采用 Language::English。
第三步:取排名靠前的编号,再换回完整工具说明
调用时,真正执行搜索的代码会先去掉首尾空格,拒绝空查询和 limit = 0;没有指定数量时默认取 8 个。核心代码很短:
rust10 行代码
let results = self.search_engine
    .search(query, limit)
    .into_iter()
    .map(|result| result.document.id)
    .filter_map(|id| self.search_infos.get(id))
    .map(|info| &info.entry);

coalesce_loadable_tool_specs(
    results.map(|entry| entry.output.clone()),
)这里有两个值得注意的细节:
- Codex 没有把 BM25 的数值分数继续传给模型,只使用检索库已经排好的顺序;
coalesce_loadable_tool_specs()会把同一工具组里的多个命中合在一起,避免返回几份重复外壳。
于是完整数据流就是:
查看源码(Mermaid)
mermaid4 行代码
flowchart TD
    A["搜索后再给的工具"] --> B["可搜索文字 + 完整工具说明"] --> C["带数字编号的 BM25 卡片"] --> D["排名靠前的编号"] --> E["按编号取回完整工具说明"] --> F["合并同一工具组"] --> G["放进下一次模型请求"]
    classDef out fill:#d3f9d8,stroke:#2f9e44
    class G out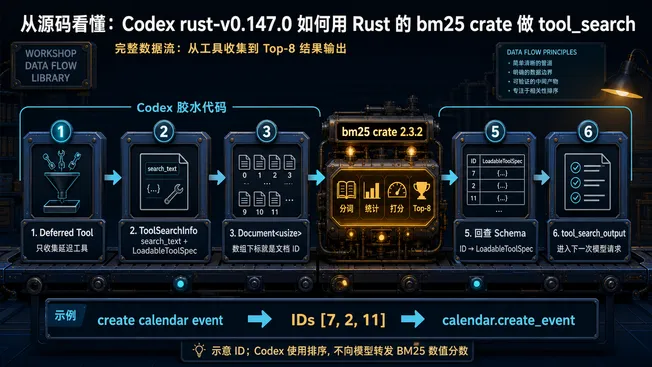
一个查询怎样走完全程
把查询设为 calendar。索引中的某张卡片可能包含下面这样的文字(为便于阅读做了缩短):
text1 行代码
create_event create event Create a calendar event title start_time end_time英文分词器会统一大小写、去掉一些没有区分度的常见词,并把词形尽量归一。BM25 如果把这张卡排在前面,程序就通过数字编号找回与它绑定的完整工具说明。搜索命中的是卡片编号,不是直接执行工具;用编号取回说明后,模型才能调用。
随后 ToolSearchOutput::to_response_item() 把结果包装成下一次请求能携带的数据。源码测试验证的格式如下;这里只保留一个空参数对象:
json14 行代码
{
  "type": "tool_search_output",
  "call_id": "search-1",
  "status": "completed",
  "execution": "client",
  "tools": [{
    "type": "function",
    "name": "create_event",
    "description": "",
    "strict": false,
    "defer_loading": true,
    "parameters": {"type": "object", "properties": {}}
  }]
}它不是普通文字,也不会回头修改第一次请求;它以 tool_search_output 的名字进入会话历史,并随下一次请求送回模型服务。这样模型就能使用本次搜索找到的完整工具说明。上面的测试只证明“结果怎样包装”,真正的先后排名由前面的 SearchEngine::search() 完成。
最后还有一个省时间的办法:ToolSearchHandlerCache 会检查工具目录是否改变。没变化就继续使用已经建好的内存索引;MCP、插件或动态工具变化后才重建。它像图书馆继续使用昨天的卡片柜,只有进了新书才重新编目。
对应源码入口可从 append_tool_search_executor()、ToolSearchHandler 和 ToolSearchEntry / search_text 构造 三处顺着读下来。
换成 Python 或 Go,照样能做
真正需要照搬的只有三步,与编程语言无关:
text3 行代码
build(cards: [{id, search_text, schema}]) -> index
search(index, query, top_k) -> ranked_ids
load(cards, ranked_ids) -> callable_schemasCodex 用 Rust 列表保存卡片、用 bm25 库排名、用数字编号取回完整工具说明。换一种语言只是在替换容器和库:
| 实现环境 | 怎样存卡片 | 怎样排名 | 命中后怎样取说明 |
|---|---|---|---|
| Rust / Codex | Vec<ToolSearchInfo> | bm25 crate | search_infos[id] |
| Python Agent | list / dataclass / dict | 任意 BM25 库或搜索服务 | cards[id]["schema"] |
| Go Agent | []ToolCard struct | 任意 Go BM25 实现或搜索服务 | cards[id].Schema |
| 多服务架构 | 数据库或工具总表 | 独立搜索服务 | 通过工具编号拉取完整说明 |
真正需要复刻的是数据契约,不是源码写法:
- 为每个工具生成高质量的可搜索文字,至少包含名称、动作、对象、参数和风险词;
- 让 BM25 返回按相关程度排好的工具编号,而不是一堆无序的“包含关键词”;
- 用编号取回完整、可检查的工具说明,并交给下一轮模型;
- 记录命中率、误召回、最终调用成功率和新增往返延迟,再决定 K 和是否增加向量召回。
因此,业务 Agent 即使完全由 Python 或 Go 编写,也可以照搬这个设计。BM25 的公式、输入卡片和排名结果不会因为编程语言改变;Rust 只是 Codex 选用的一种实现方式。
为什么这个场景选 BM25 很合理
源码明确告诉我们“用了什么”,但没有留下“为什么选它”的设计备忘录。根据数据特点判断,BM25 很适合从大量工具里找候选:
- 工具说明短,而且技术词很明确。
calendar、pull_request、spawn_agent、issue_number这类名字和参数本来就适合按关键词找; - 可以完全在本机建立索引。 不需要请求向量模型,也不需要维护向量数据库;
- 工具目录经常变化。 MCP、插件或动态工具可能随时增减,BM25 重建快、成本低,也容易解释为什么排在前面;
- 这里只需要缩小范围,不需要回答开放问题。 搜索把几十或几百张工具卡缩成几张,再让模型做最终选择;
- 精确技术词不能被“语义相似”冲淡。
delete_issue与get_issue语义相关,但权限风险完全不同。名称与参数的词法证据在工具选择里很重要。
简单的“字符串里有没有这个词”不会认真排序;向量搜索虽然更擅长同义词和跨语言,却要增加模型服务、索引维护,也可能把“意思相近但不能乱用”的工具排在一起。对短小的工具说明来说,BM25 是一个务实的中间选择。
BM25 的边界也很清楚
当前实现只按英文文字搜索,没有再加向量搜索、同义词表、工具名额外加分或第二轮精排。因此这些查询并非它的强项:
- 中文问“安排会议”,工具只写
create_calendar_event; - 用户说“查代码评审”,工具只写
pull_request_review; - 两个工具的说明大量使用相同套话,真正差异没有明确写出来。
这也是为什么工具名称、用途和参数说明不能随便写。BM25 像馆员,但只能阅读卡片上已有的字。好的卡片要写出用户会说的动作、对象、限制和危险性。工具更多、语言更多或表达更灵活时,可以升级成 BM25 先找一批 + 工具名完全命中时加分 + 再做一次轻量精排,不必立刻全部改成向量搜索。
BM25 能不能用来搜索记忆
能用,但更适合负责“按原词找一批候选”,不能单独承担完整的长期记忆。 还要先澄清一个源码事实:这个稳定版 Codex 搜索记忆时并没有使用 BM25,而只是查找“文字里是否包含查询内容”,再按文件路径和行号整理结果。
为什么 BM25 仍值得用在 Memory?错误码、函数名、文件路径、项目代号、人名和已经写入的决策措辞,都是非常强的词法锚点。用户问“上次 EADDRINUSE 怎么处理”,BM25 往往比纯向量更稳定,也比子串匹配更会给结果排序。
但记忆比工具卡更难:同一件事可能换一种说法,旧结论可能被新结论推翻,还要考虑“谁的记忆、哪个项目、多久以前、可信度多高”。BM25 不理解这些关系:
| 记忆搜索需求 | 只用 BM25 的效果 |
|---|---|
| 精确名称、路径、错误码、API | 强 |
| 同义改写、跨语言表达 | 弱 |
| 用户 / 项目 / 时间范围 | 需要先按这些信息筛选 |
| 新旧结论冲突、可信度和重要性 | 需要额外排序与治理 |
一个更可靠的生产方案是:
查看源码(Mermaid)
mermaid6 行代码
flowchart TD
    A["先按用户 / 项目 / 时间筛选"] --> B1["BM25 按原词找"] & B2["向量搜索按意思找"]
    B1 & B2 --> C["合并两边的候选"]
    C --> D["按新鲜度、重要性、可信度、使用次数加权"] --> E["再做一次轻量精排"] --> F["返回原文片段与出处"]
    classDef out fill:#d3f9d8,stroke:#2f9e44
class F out对于很小、主要存技术日志的本地记忆,先用 BM25 完全合理;它至少会比简单的“包含文字”多一层有效排序。自然语言转述、跨语言和冲突记忆增多后,再升级成“按原词找 + 按意思找”。这是通用建议,不是说 Codex 当前已经这样实现。
开源 Codex 可以换模型,但不是只改一个名字
准确的说法不是“把 GPT-5.6 变成 DeepSeek、GLM 或 Kimi”,而是:保留 Codex 这套 Agent 外壳,换掉背后的模型和模型接入层。 Codex CLI、SDK 和 App Server 等核心组件已经开源,所以沙箱、操作确认、工具总表、MCP 外部工具、会话历史和执行循环都可以继续复用。
最小控制循环与具体模型品牌无关:
查看源码(Mermaid)
mermaid7 行代码
flowchart TD
    A["用户任务 + 会话记录 + 工具说明"] --> B["模型接入层"]
    B --> C["工具调用 / 文字回答"]
    C --> D["Codex 执行、请求确认、记录结果"]
    D -->|"下一轮模型请求"| B
    classDef swap fill:#e5dbff,stroke:#6741d9
class B swap但模型替换不是只改一行 model = "..."。至少要保证三层能够对上:
| 适配层 | 必须对齐什么 | 没对齐时的表现 |
|---|---|---|
| 网络连接 | 地址、密钥、请求头、流式连接、失败重试 | 连不上、401、回答到一半中断 |
| 数据格式 | 问题、工具调用、工具结果、流式事件和错误分别怎样表示 | 能聊天,但一调用工具就断 |
| 模型能力 | 能读多长、能否稳定按格式调用工具、能否并行、能否搜索工具 | 请求能跑,但 Agent 变笨或功能消失 |
官方配置允许自定义模型接入层。如果业务网关已经支持 Codex 使用的 Responses 请求格式,最短配置类似:
toml8 行代码
model = "your-business-model"
model_provider = "business_gateway"

[model_providers.business_gateway]
name = "Business model gateway"
base_url = "https://llm-gateway.example.com/v1"
env_key = "BUSINESS_LLM_API_KEY"
wire_api = "responses"这里必须结合本文固定版本加一句重要限制:rust-v0.147.0 的 WireApi 只接受 responses,并明确拒绝 wire_api = "chat"。因此接入 DeepSeek、GLM、Kimi 或其他业务模型时:
- 若服务端完整兼容 Responses、流式回答和工具调用,可以先从自定义模型接入配置开始;
- 若只有 Chat Completions 一类接口,需要加一个网关,在 Codex 格式与厂商格式之间双向翻译;也可以直接修改开源的模型接入代码;
- “接口能返回文字”不等于 Agent 已适配完成,还要实际测试工具调用、结果回传、长对话、错误恢复和并行调用。
还有一个关键细节:Codex 不认识的新模型会采用一套 保守默认设置,先关闭工具搜索、精简请求、exec 集中调用和并行工具。也就是说,换模型后,简单的“模型点名工具 → 程序执行 → 结果交回”可能先跑起来,但 GPT-5.6 的特殊优化不会自动继承。要重新打开它们,必须补充该模型的能力说明,并用实际任务证明它确实做得稳。
对业务团队来说,最快且风险最低的迁移顺序是:
- 先让新模型完成文字回答和少量直接工具调用;
- 验证参数填写、工具调用与结果能否成对、回答中断后能否恢复、长对话能否压缩;
- 用业务任务集比较成功率、成本和延迟,而不是只看聊天效果;
- 再逐步打开并行调用、按需搜索工具、
exec集中调用等高级能力。
这才是开源 Agent 框架的真正复用价值:不必重写成熟的执行和安全底座,只替换模型接入部分,再把业务工具、规则、记忆和评测加在自己可控的层上。
最值得带走的七点
第一,第一次请求不会把所有工具都塞给模型;程序会根据模型、环境和功能开关,决定哪些一开始就给、哪些搜索后再给、哪些不给。
第二,公开 Responses API 把工具放在顶层 tools;Codex 的内部 Responses Lite 才把它们放进 additional_tools 输入项。两者都是结构化数据,不是藏在 system 或 user 提示词中。
第三,tool_search 由模型按需选择,不是每轮自动执行;搜到的工具说明留在同一会话里,后面可以继续使用。
第四,把大量工具收进 exec 需要模型更会写代码和组织工具,但源码没有证明“模型更强”是 GPT-5.6 使用它的唯一原因。
第五,BM25 仍然是关键词搜索,只是会认真排序。它适合工具说明,也适合从记忆中找错误码、路径等原词;完整记忆还需要按项目和时间筛选、按意思搜索、再次精排。
第六,“可搜索文字 → 排名后的编号 → 完整工具说明”与语言无关,可以在 Rust、Python、Go 或独立搜索服务中复现。
第七,开源 Codex 可以替换模型,但网络连接、请求格式和模型能力必须同时对上;新模型不会自动继承 GPT-5.6 的工具搜索和 exec 调用方式。
源码索引
- GPT-5.6 Sol 模型能力与 Tool Mode
- GPT-5.6 Terra 的 Code Mode Only 配置
- GPT-5.6 Luna 的 Code Mode Only 配置
- GPT-5.5 相邻模型条目没有选择 Code Mode Only
- OpenAI Tool Search 官方指南:Deferred Loading、调用时序与未来轮次复用
- OpenAI Programmatic Tool Calling 官方指南
- Codex 自定义 Model Provider 官方配置
- Codex 开源组件边界
- Tool Registry、Exposure 与首轮可见 Spec 规划
- 核心 Tool 的条件化注册
- Responses Lite 的
additional_tools请求封装 - Responses Lite 测试:内部请求头、顶层字段缺席与输入项顺序
tool_search的 BM25 Engine 与 Top-K 返回- Tool Search 索引文本如何由名称、描述和 Schema 组成
tool_search结果如何变成下一次请求的专用输入项tool_search_call/tool_search_output如何保留在会话历史- MCP Tool 的 Direct / Deferred 注册策略
- BM25 crate 版本:2.3.2
bm252.3.2 的公式与默认参数bm252.3.2 默认分词器的切词、归一、停用词与词干化- Codex Memory Tool 当前的子串查询语义
- Codex Memory 本地搜索与结果排序实现
- 稳定版只接受 Responses Wire API,并拒绝旧
chat配置 - 未知模型怎样落到保守的 fallback capability metadata
源码核对日期:2026-08-09。稳定版固定到
be6e8eac,同时核对了当日main的646f7c0a;BM25 库固定到v2.3.2的8ef72604。模型能看到哪些工具以及模型目录都会继续变化,排查具体环境时应以实际请求和对应 commit 为准。
配图生成说明:中英文两版共六张技术图,均通过 Codex 内置
image_gen.imagegen生成或编辑;在固定版本源码中,该扩展把IMAGE_MODEL写死为gpt-image-2,并用它构造图片请求。发布前人工复核了模式状态、返回数量、示意编号和中英文标签。