生产环境 Agent 实践 — 为什么我们从 Celery 迁移到 Temporal
2026 年 4 月,我们把 seo-project 的任务队列从 Celery 全面迁移到了 Temporal。删除的依赖只有一个(celery),新增的核心代码有 11 个文件(src/infrastructure/temporal/),容器从 api/worker/beat 变成了 api/temporal_worker_blue/green(蓝绿部署)。
目录 · index
这件事做完后,最常被问到的问题是:为什么不用 Celery?已经能跑的东西换它干什么?
这篇文章就是答案。它不来自文档对比,来自生产环境跑 Agent 流水线时逐条撞上的坑。
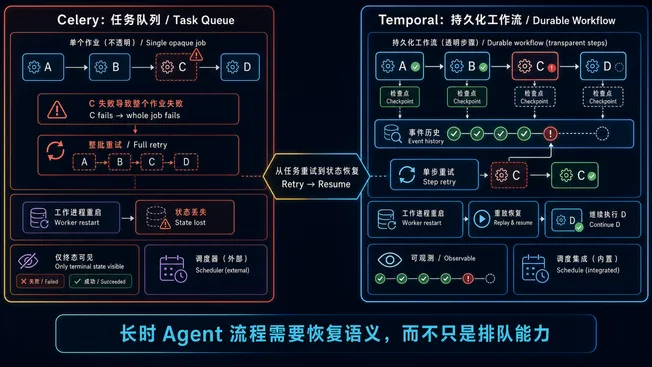
这张图先划清两个工具的问题层级。Celery 负责把任务交给 Worker;Temporal 额外保存事件历史,让多阶段流程能够从故障点恢复。迁移的核心不是换一个更快的队列,而是获得可重放的状态机。
Celery 能做的事,为什么在 Agent 场景里开始不够用
先说清楚一个基本判断:Celery 是好工具。对于”发封邮件、生成一张缩略图、推送一条通知”这类标准异步任务,它完全够用,工业界跑了十几年。
但我们跑的负载和这不一样:
text6 行代码
一个 Run 包含 N 条 longtail
每条 longtail 跑 A → B → C → D 四个 Agent 阶段
每个阶段调一次或多次 AI API
总耗时任意一条都在 60-180 秒区间
每一步的中间结果需要持久化
任何一步失败需要知道"停在哪、为什么、能不能只重试这一步"这是有状态的、长时的、多阶段的业务流程。任务队列和业务流程引擎之间的分界线,就在这里。
第一条裂缝:任务状态只有”成功”和”失败”
Celery 的任务模型是:入队 → worker 拿到 → 执行 → 成功 or 失败。中间过程是一个黑盒。
当 Agent D 在生成 SEO 元数据时超时了,Celery 告诉你的是:“task failed, state=FAILURE”。但你想知道的是:
- Agent A(关键词分析)成功了吗?结果是什么?
- Agent B(大纲生成)跑完了吗?
- Agent C(正文生成)生成的 HTML 落库了没有?
- Agent D 是在调哪个模型时超时的?重试应该从 D 重跑,还是从 C 重跑?
这些问题,Celery 的答案都是”你自己记”。你可以往 Redis/DB 里写状态,但你本质上是在任务队列上手工搭状态机——而这恰恰是 Temporal workflow 的原生能力。
Temporal 的 workflow 代码就是你写的那段业务逻辑,每一步执行到哪、什么值、抛了什么异常,全部自动持久化。Worker 重启后 workflow 从断点继续,不需要任何额外代码。
pythonCelery 版本:你要自己管每一步的状态21 行代码
# Celery 版本:你要自己管每一步的状态
@app.task(bind=True, max_retries=3)
def run_pipeline(self, longtail_id):
    try:
        result_a = agent_a(longtail_id)        # 如果这里成功
        save_checkpoint("step_a_done", result_a)
        result_b = agent_b(result_a)           # 这里失败
        # 重试时你从哪开始?自己判断 checkpoint
    except Exception:
        self.retry()

# Temporal 版本:workflow 代码就是状态机
@workflow.defn
class PipelineWorkflow:
    @workflow.run
    async def run(self, longtail_id: str) -> dict:
        result_a = await workflow.execute_activity(agent_a, longtail_id)
        result_b = await workflow.execute_activity(agent_b, result_a)
        result_c = await workflow.execute_activity(agent_c, result_b)
        result_d = await workflow.execute_activity(agent_d, result_c)
return result_d注意 Temporal 版本里没有 checkpoint 管理代码。如果 agent_c 超时,重试直接从 agent_c 开始——agent_a 和 agent_b 的返回值已经持久化在 workflow history 里,不需要重新执行。
第二条裂缝:整批回滚——“一条超时,八条陪葬”
这是真正的生产事故。
我们的 Agent 批量流水线是:一个 task 里循环跑 N 条 longtail,每条跑 A→B→C→D。历史代码把数据库 commit 放在循环外面:
python反模式:整批一个事务5 行代码
# 反模式:整批一个事务
async with unit_of_work(autocommit=False) as uow:
    for longtail in batch:
        await run_pipeline(longtail)
await uow.commit() # 一次提交所有问题来了:第 3 条的 Agent C 调 AI 超时 → SQLAlchemy session 进入 invalid 状态 → 第 4-8 条所有后续 get/save/commit 全部抛 PendingRollbackError → 整批 8 篇文章一个没落库。
修复方案是把事务边界收缩到单条 longtail:每轮自己 commit,失败那轮也 commit 失败状态。配合 Temporal 后,这个模式变得更自然——每条 longtail 是一个独立的 workflow execution,Temporal 原生保证它的幂等性和可重放性。
Celery 模型里,task 失败 = 整个 task 回滚 = 你要自己控制重试粒度。Temporal 模型里,一个 workflow 的失败不影响其他 workflow,每条 workflow 的 history 独立可查。运营看到的是 “1 failed / 7 succeeded” 而不是 “8 vanished”。
第三条裂缝:长时任务与 Worker 重启
Agent 流水线单条跑 60-180 秒是常态。Celery 的 worker 重启(部署、OOM、节点回收)会直接杀掉正在跑的任务,默认行为是 ack 后重新入队——从头开始跑。
这对短任务(<5 秒)问题不大。对一条已经跑了 120 秒、AI token 已经烧了十几万、就差最后一步的 Agent 流水线来说,从头跑意味着前面的 token 成本全部白费。
Temporal 的 durable execution 模型不同:即使 worker 重启,workflow 状态在 Temporal Server 中持久存在。新 worker 拿到 workflow history,从最后完成的步骤继续执行。这对于 AI 流水线的成本控制有直接意义。
第四条裂缝:排障时看不到”发生了什么”
生产上一条 Agent 流水线失败后,Celery 的排障路径是:
- 找到 task ID
- 去 Flower(如果装了)看 task 状态
- grep 应用日志里的 trace_id
- 手动拼出”A 生成了什么 → B 生成了什么 → C 卡在哪一步”
- 如果中间有重试,信息更乱
Temporal 的排障路径是:
- 打开 Temporal Web UI
- 点进这个 workflow execution
- 每一步的输入、输出、耗时、异常信息全部可视化在一条时间线上
- 你可以直接看到”Agent C 的
generate_articleactivity 在第 47 秒超时,重试了 2 次,每次的 prompt 和返回的 HTML 片段都可以展开查看”
这不是”Temporal 有个好看的 UI”,而是 调试效率的量级差异。对于多 Agent 流水线这种”调用链长、状态多、中间产物重要”的场景,可视化的 workflow history 是刚需,不是锦上添花。
第五条裂缝:定时调度的可靠性
Celery Beat 是一个独立进程,用 celery beat 启动。它的常见问题:
- Beat 挂了 → 定时任务停了,没有 failover
- Beat 重启 → 可能重复触发同一时间的任务
- 错过了调度窗口 → 不会自动补发,需要手工处理
schedule变更 → 需要重启 Beat
我们在 Agent 项目中有一个需求:每天为每个站点生成一批文章。如果某天调度器宕机或错过窗口,需要自动检测缺失日期并补发。
Celery 做这件事的方案是”写个脚本对比日期差,手动投递”。Temporal Schedule 原生支持:
- Overlap Policy: 上一个 workflow 还在跑时下一次触发怎么办
- Catch-up Window: 错过了多久以内的窗口自动补发
- Pause/Resume: 不需要改 cron 表达式,直接暂停调度
对于内容生产这类”错过一天就得补”的业务,Schedule 的补发语义是硬需求,不是 nice-to-have。
选型对照表
| 维度 | Celery | Temporal | Agent 场景谁赢 |
|---|---|---|---|
| 任务模型 | 无状态 task | 有状态 workflow | Temporal(Agent 流水线天然有状态) |
| 中间状态持久化 | 自己实现(Redis/DB) | 自动持久化 workflow history | Temporal(零额外代码) |
| 重试语义 | task 级别重试,从头跑 | activity 级别重试,断点续跑 | Temporal(长时 AI 调用 token 成本差异大) |
| 失败可视性 | 日志 grep + Flower | Web UI 时间线 + 每步 I/O | Temporal(排障效率量级差异) |
| 定时调度 | Beat 进程,无 failover | Schedule,内置 catch-up | Temporal(内容补发是硬需求) |
| 批量任务失败半径 | 取决于你怎么写 commit | 每条 workflow 天然隔离 | Temporal(独立幂等单元) |
| Worker 重启影响 | 正在跑的任务丢失,从头重试 | workflow 从断点恢复 | Temporal(120 秒的 AI 调用不白跑) |
| 运维复杂度 | Worker + Beat + Flower + Broker (Redis/RabbitMQ) | Worker + Server (自带 Web UI) | 相当(Temporal Server 需要独立部署,但省了 Flower 和 Beat 的运维) |
| 学习曲线 | 低(Python 生态原生) | 中(workflow/activity 确定性约束需要理解) | Celery 胜(上手更快) |
| 适用场景 | 短时、无状态、失败成本低 | 长时、有状态、中间产物重要、需要可审计 | 看任务性质 |
什么时候你不需要 Temporal
不是说 Celery 就该被替换。如果你面对的是下面这些场景,Celery 仍然是最优解:
- 任务耗时 <10 秒,失败从头跑成本可以忽略
- 不需要看到中间步骤的输入输出(比如发邮件)
- 不需要按步骤重试(整个任务成功或失败即可)
- 团队对 Temporal 的确定性约束不熟悉,短期无学习预算
- 现有 Celery 系统运行稳定,迁移收益 < 迁移成本
我们的决定不是”Temporal 比 Celery 好”,而是 “Agent 流水线的特征恰好卡在 Celery 的薄弱面和 Temporal 的核心能力之间”。
迁移后落地的架构模式
迁移到 Temporal 后,几个关键的架构决策也随之定型:
1. 一条 longtail = 一个 workflow = 一个事务边界
批量任务变成”外层投递 N 个 workflow,内层每个 workflow 独立管理自己的事务”。这是 concepts/backend 中”[数据库] 批量任务:per-iteration 事务边界”和 Temporal 的天然结合。
2. Unit of Work 的两种语义
FastAPI 路由用 autocommit=True(请求级短事务),Temporal worker 用 autocommit=False(workflow 级长事务,自己接管 commit/rollback 时机)。同一套 UoW 代码,不同的生命周期语义。
3. 蓝绿部署
容器从单实例 worker 变成 temporal_worker_blue + temporal_worker_green。发版时先切流量到新颜色,旧颜色等正在跑的 workflow 全部完成后再回收。这是 Temporal Task Queue 的 routing 能力带来的零停机部署。
4. 幂等重放是免费的
每条 workflow execution 的 history 存在 Temporal Server 里。出问题时,你可以用同一份 history 在本地重放整个 workflow——输入相同、路径相同、数据库操作被 mock 掉——来定位是哪个 activity 的哪次调用的哪个返回值导致了错误。这在 Celery 时代是好几个小时的体力活。
总结
把 Temporal 当成”更强大的 Celery”是对两者的误解。它们解决的是不同层级的问题:
- Celery 解决的是”把一段代码放到另一台机器上跑”
- Temporal 解决的是”保证一段多步骤业务流程可靠地跑到终点,并让过程中的每一步都可审计”
Agent 流水线恰好是一个多步骤、长耗时、中间产物重要、失败代价高的业务流程。用任务队列去模拟业务流程引擎,不是在用错工具——是用了正确工具的上一个版本,然后手工实现了正确工具已经内置的能力。
这篇文章基于 seo-project 的生产实践。迁移记录见 LLM Wiki → log.md (2026-04-10) 及 concepts/backend.md。